
Meta が公開している AI エージェント「MUSE」には、自分好みのアバターを作って動かせる機能があります(参考: Axios の報道)。
私も参考画像を使って、自分専用のアバターを作ってみました。
画像を作るところまでは、かなりうまくいったのですが、「状態ごとに違う姿を設定する」ところで思わぬ壁にぶつかりました。
この記事は、その試行錯誤をそのまま記録した検証メモです。
先に結論
- できた: 参考画像の雰囲気を保った生成、ポーズ・表情・小物の文章指定、部分だけの採用、動くバージョンの作成
- できなかった: 待機中・作業中など、状態ごとに別の姿を割り当てること
- 今の現実的な対処: いちばん見せたい姿を1つ決めて、全状態で統一する
この記事は、2026年11月時点の私の環境で試した結果です。
MUSE の機能は今後変わる可能性があるので、「いまはこうだった」という記録として読んでください。
まず、何をしようとしたのか
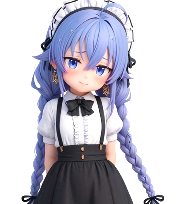
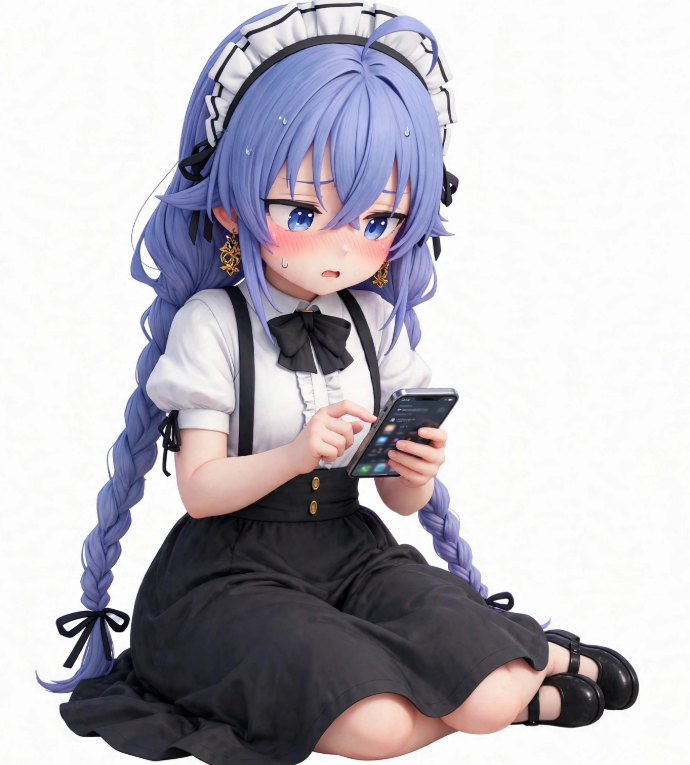
きっかけはシンプルで、推しキャラクター (無職転生のロキシー) を、自分用の AI アシスタントのアバターを作りたかったんです。
顔や髪型、衣装のイメージを参考画像に寄せて生成して、チャット画面で動く姿まで作るのが最初の目標でした。
※ 以下がイメージです。
そのうえで、欲が出てきました。
私の環境ではアバターに表示状態が4つあったので、状態ごとに違うポーズを持たせたくなったんです。
| 表示順 | 状態 | やりたかったこと |
|---|---|---|
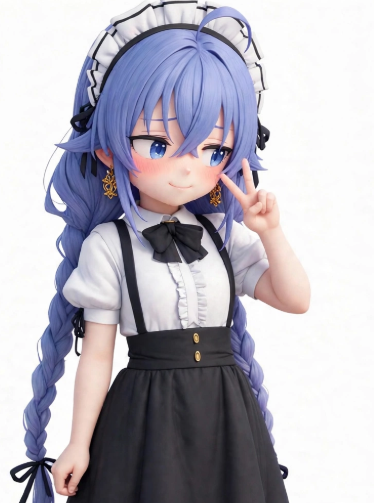
| 1番目 | 待機中(Idle) | 立ち姿で顔の横に逆さピース。頬を赤らめた照れた表情。物は持たない |
| 2番目 | 作業中(Working) | 床に座った横座りで、スマートフォンを必死に操作する姿 |
| 3番目 | 作っている時(Creating) | 当時の設定をそのまま維持する |
| 4番目 | レベルアップ時(Level Up) | 当時の設定をそのまま維持する |
文章で読むと、当然できそうに思えますよね。
実際、画像生成の部分はかなりうまくいきました。
問題は、その先の「割り当て」で起きました。
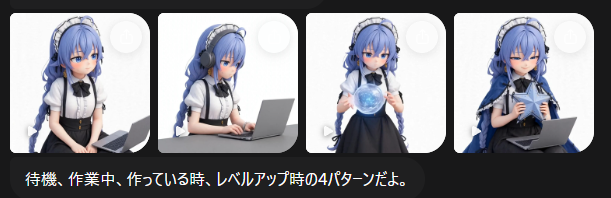
※ 待機、作業中、作っているとき、レベルアップ時の参考画像
できたこと:画像づくりはかなり自由度が高い
参考画像の雰囲気を保ったまま生成できる
参考画像を渡すと、キャラクターの核になる要素を維持した新しいアバターを生成できました。
顔の印象・髪型・髪色・瞳の色、衣装やアクセサリーのデザインが維持されて、全身が自然に見える立ち姿など、構図を指定して作り直すこともできます。
完全に同一人物を再現するわけではありませんが、「同じキャラクターの別の1枚」として十分に通用するレベルでした。
ブログのアイコンやチャットの顔として使うだけなら、ここだけでも価値があります。
ポーズ・表情・小物を文章で細かく指定できる
仕様を文章で分解して伝えると、かなり細かいニュアンスまで反映されました。
指定できた例は次のとおりです。
※ プロンプトの生成は ChatGPTやClaudを使うのがオススメ
- ポーズ: 片手を顔の横に上げ、手のひらを外側に向けた逆さピース。もう片方の手は体の横に自然に添える
- 表情: 頬をほんのり赤くする、少し困ったような照れた目つき、控えめな微笑み
- 小物: スマートフォンは1台だけ持たせる
- 禁止事項: ヘッドホンやヘッドセットは付けない、パソコン・机・椅子は置かない
特に効いたのが、「付けないでほしいもの」を明記する指定です。
パソコン作業のイメージではヘッドホンが付きがちですが、付けないよう指定すると外した姿で生成できました。
部分だけを参考画像から採用できる
「この画像全体ではなく、足の表現だけを採用してほしい」という部分指定も通じました。
座り姿の生成では、最初は脚が前に伸びた姿勢になってしまいました。
そこで座り方の参考写真を別途渡し、「イメージ画像として、脚の向きだけを今のアバターに反映してほしい」と限定したところ、両膝を曲げて脚を片側へ流す横座りに修正できました。
全体を作り直すのではなく、直したい部位と、変えてはいけない部位(顔・髪・衣装・表情)を分けて伝えるのがコツです。
静止画から動くバージョンを作れる
決まった1枚のアバターから、動くバージョンを生成してチャット画面に表示できました。
自然なまばたきや呼吸に合わせたわずかな動き、髪や衣装の小さな揺れ、視線をそらす・こちらをちらっと見るといった小さな視線移動、小さく首を傾げるなど、控えめにループする動きが作れます。
作業中の姿なら、画面をタップする、焦って何度かタップする、首を傾げてから再び操作する、といった一連の流れも指定できました。
動きは大げさにしないよう指定するのがポイントです。
「長時間表示していても違和感のない、自然で滑らかなループ」と添えると、落ち着いた待機アニメーションになりました。
できなかったこと:状態ごとの使い分けはできなかった
状態ごとに別の画像を割り当てられない
今回いちばん大きな失敗がここです。
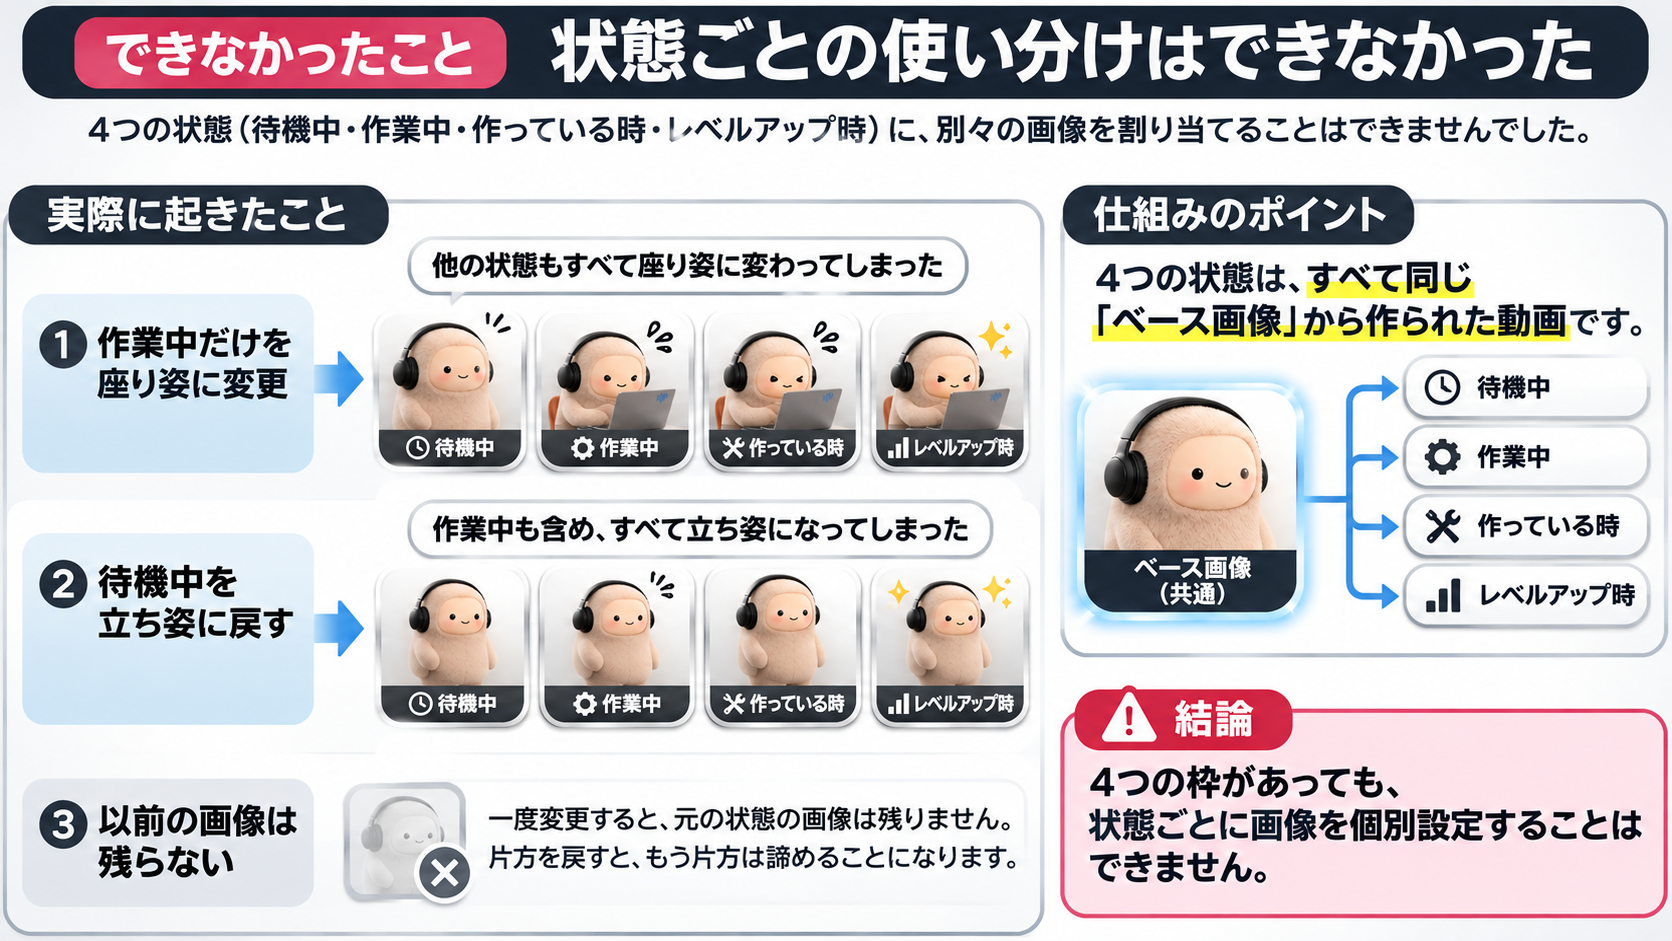
作業中だけを変更したつもりが、待機中まで作業中の姿に変わってしまいました。
確認した結果、仕組みはこうなっていました。
私の環境で起きたこと
MUSE 側の説明では、待機中・作業中・作っている時・レベルアップ時の4状態は、すべて同じベース画像から作られた動画を表示しているとのことでした。
実際に、1状態を変更すると他の状態にもそのまま反映され、ベース画像そのものを変更したのと同じ結果になりました。
実際に起きたことを並べると、次のようになります。
- 作業中を座り姿に変える → 待機中・作っている時・レベルアップ時も座り姿になる
- 待機中を立ち姿に戻す → 作業中も立ち姿になる
- 以前の状態の画像は残らないため、片方を戻すと、もう片方は諦めることになる
状態ごとに画像を個別に紐付ける操作は、今回使えた機能の中にはありませんでした。
「4つの枠がある=4枚別々に設定できる」と思い込むと、つまずきやすいと思います。私はつまずきました。
細かい動作は一発では決まらない
大まかなポーズは通じても、細部は初回生成で外れることが何度もありました。
| 起きたこと | 何が違ったか | どう直したか |
|---|---|---|
| 座り姿の脚の向き | 横座りを指定したのに、脚が前に伸びた姿勢になった | 座り方の参考写真を渡し、脚だけを採用するよう限定した |
| スマートフォンの操作感 | 持っているだけで、操作しているように見えなかった | 指が画面に触れてタップしている途中であることを明記した |
| 状態の取り違え | 作業中の変更が待機中に適用されたように見えた | ベース画像の共有が原因と考えられた。優先する状態を1つ決めた |
教訓は、「座っている」「操作している」のような言葉だけでは足りないことです。
関節の向き、指と画面の接触、体の前傾具合まで言葉にするか、参考画像で示す必要があります。
それでも1回で決まるとは限らないので、修正は2〜3回を前提に考えたほうが現実的です。
現状の現実的な使い方とまとめ
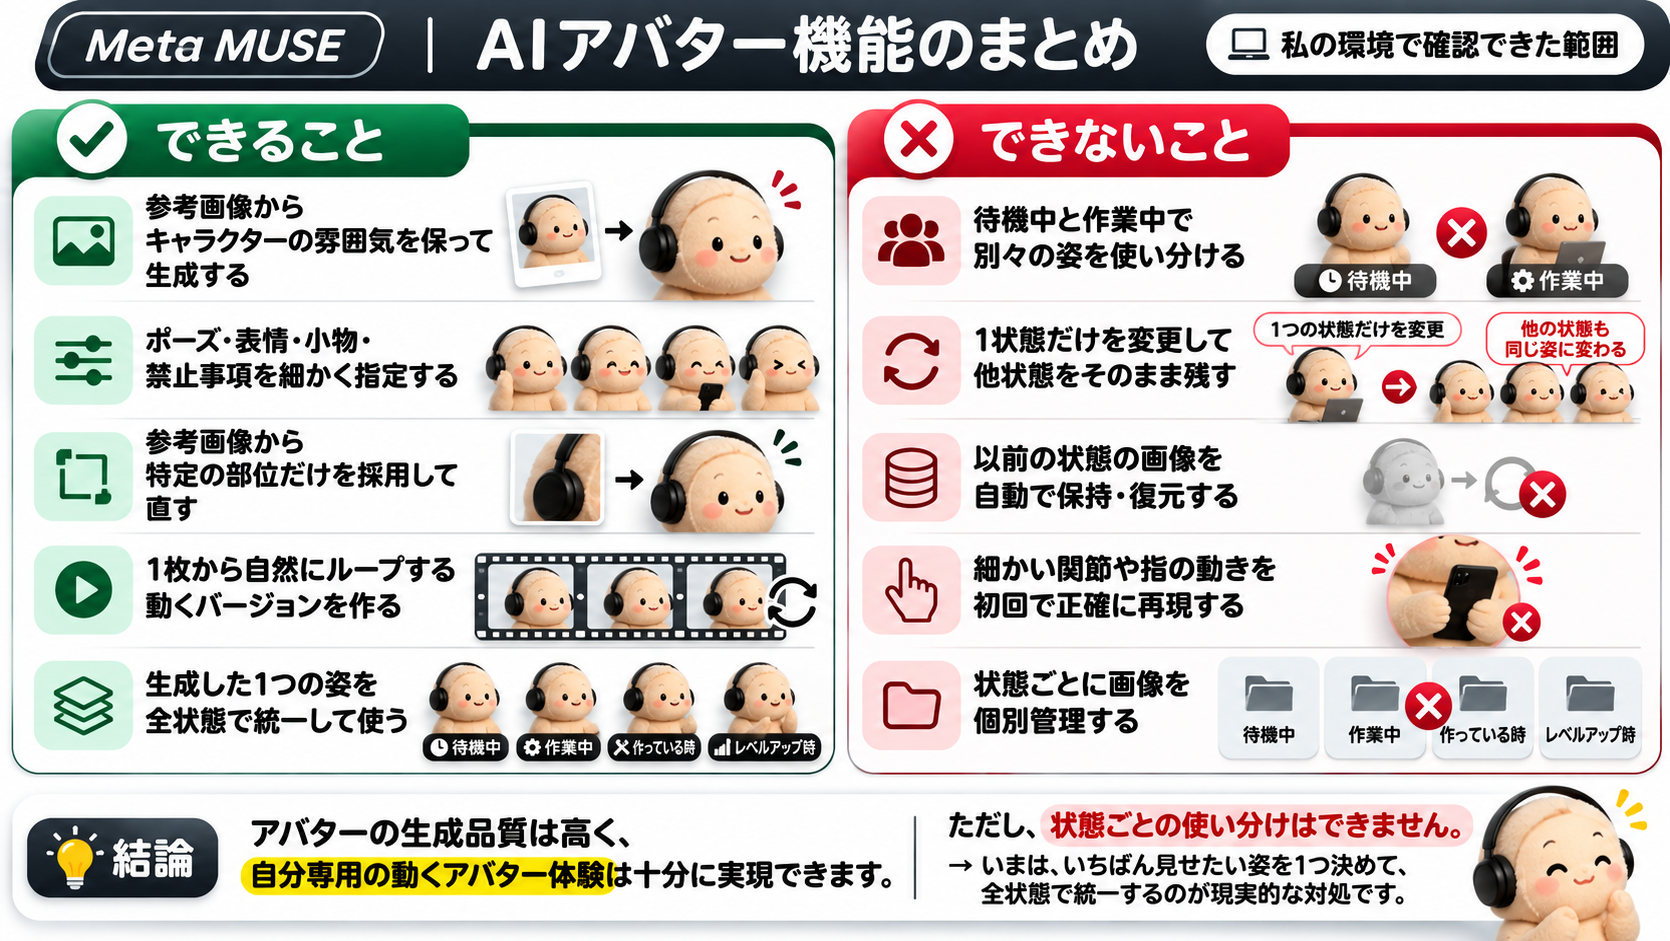
私の環境で確認できた範囲を、できること・できないことで整理します。
| できること | できないこと |
|---|---|
| 参考画像からキャラクターの雰囲気を保って生成する | 待機中と作業中で別々の姿を使い分ける |
| ポーズ・表情・小物・禁止事項を細かく指定する | 1状態だけを変更して、他状態をそのまま残す |
| 参考画像から特定の部位だけを採用して直す | 以前の状態の画像を自動で保持・復元する |
| 1枚から自然にループする動くバージョンを作る | 細かい関節や指の動きを初回で正確に再現する |
| 生成した1つの姿を全状態で統一して使う | 状態ごとに画像を個別管理する |
アバター生成の品質自体には満足しています。
参考画像のキャラクター性を保ちながら、照れた表情や座り姿、スマートフォンを操作する様子まで、文章の指定で作り込めました。
動くバージョンまで含めれば、「自分専用のアバターがチャットで動く」という体験は十分に実現できます。
一方で、状態ごとの使い分けは現状できません。
ここを期待して設定を進めると、今回のように「変えたつもりが全部変わっていた」という失敗になりかねません。
いまは、いちばん見せたい姿を1つ決めて、全状態で統一するのが現実的な対処だと考えています。
機能が進化して状態別の割り当てができるようになれば、本来やりたかった演出が可能になります。
その日が来たら、また検証して続編を書くつもりです。
。 私も参考画像を使 ...)